Jev オセロ検証:問い方
この記事の要点
- 問い方:オセロの原則を雑に書き足しても差は出ず(55勝2分43敗)、専門家の教材から作った7つの原則を書き足すと勝ち越した(71勝2分27敗)。
- 分解と計算:原則を小さな「はい / いいえ」の質問に分けただけでは、1問で聞く方式と差が見えなかった(47勝4分49敗)。分けた質問の答えを Python で計算して渡すと、はっきり強くなった。
- 汎用 LLM との比較:最も強い方式でも Claude Haiku 5.5 には負け越した。速さと費用では Jev が大きく上回った。
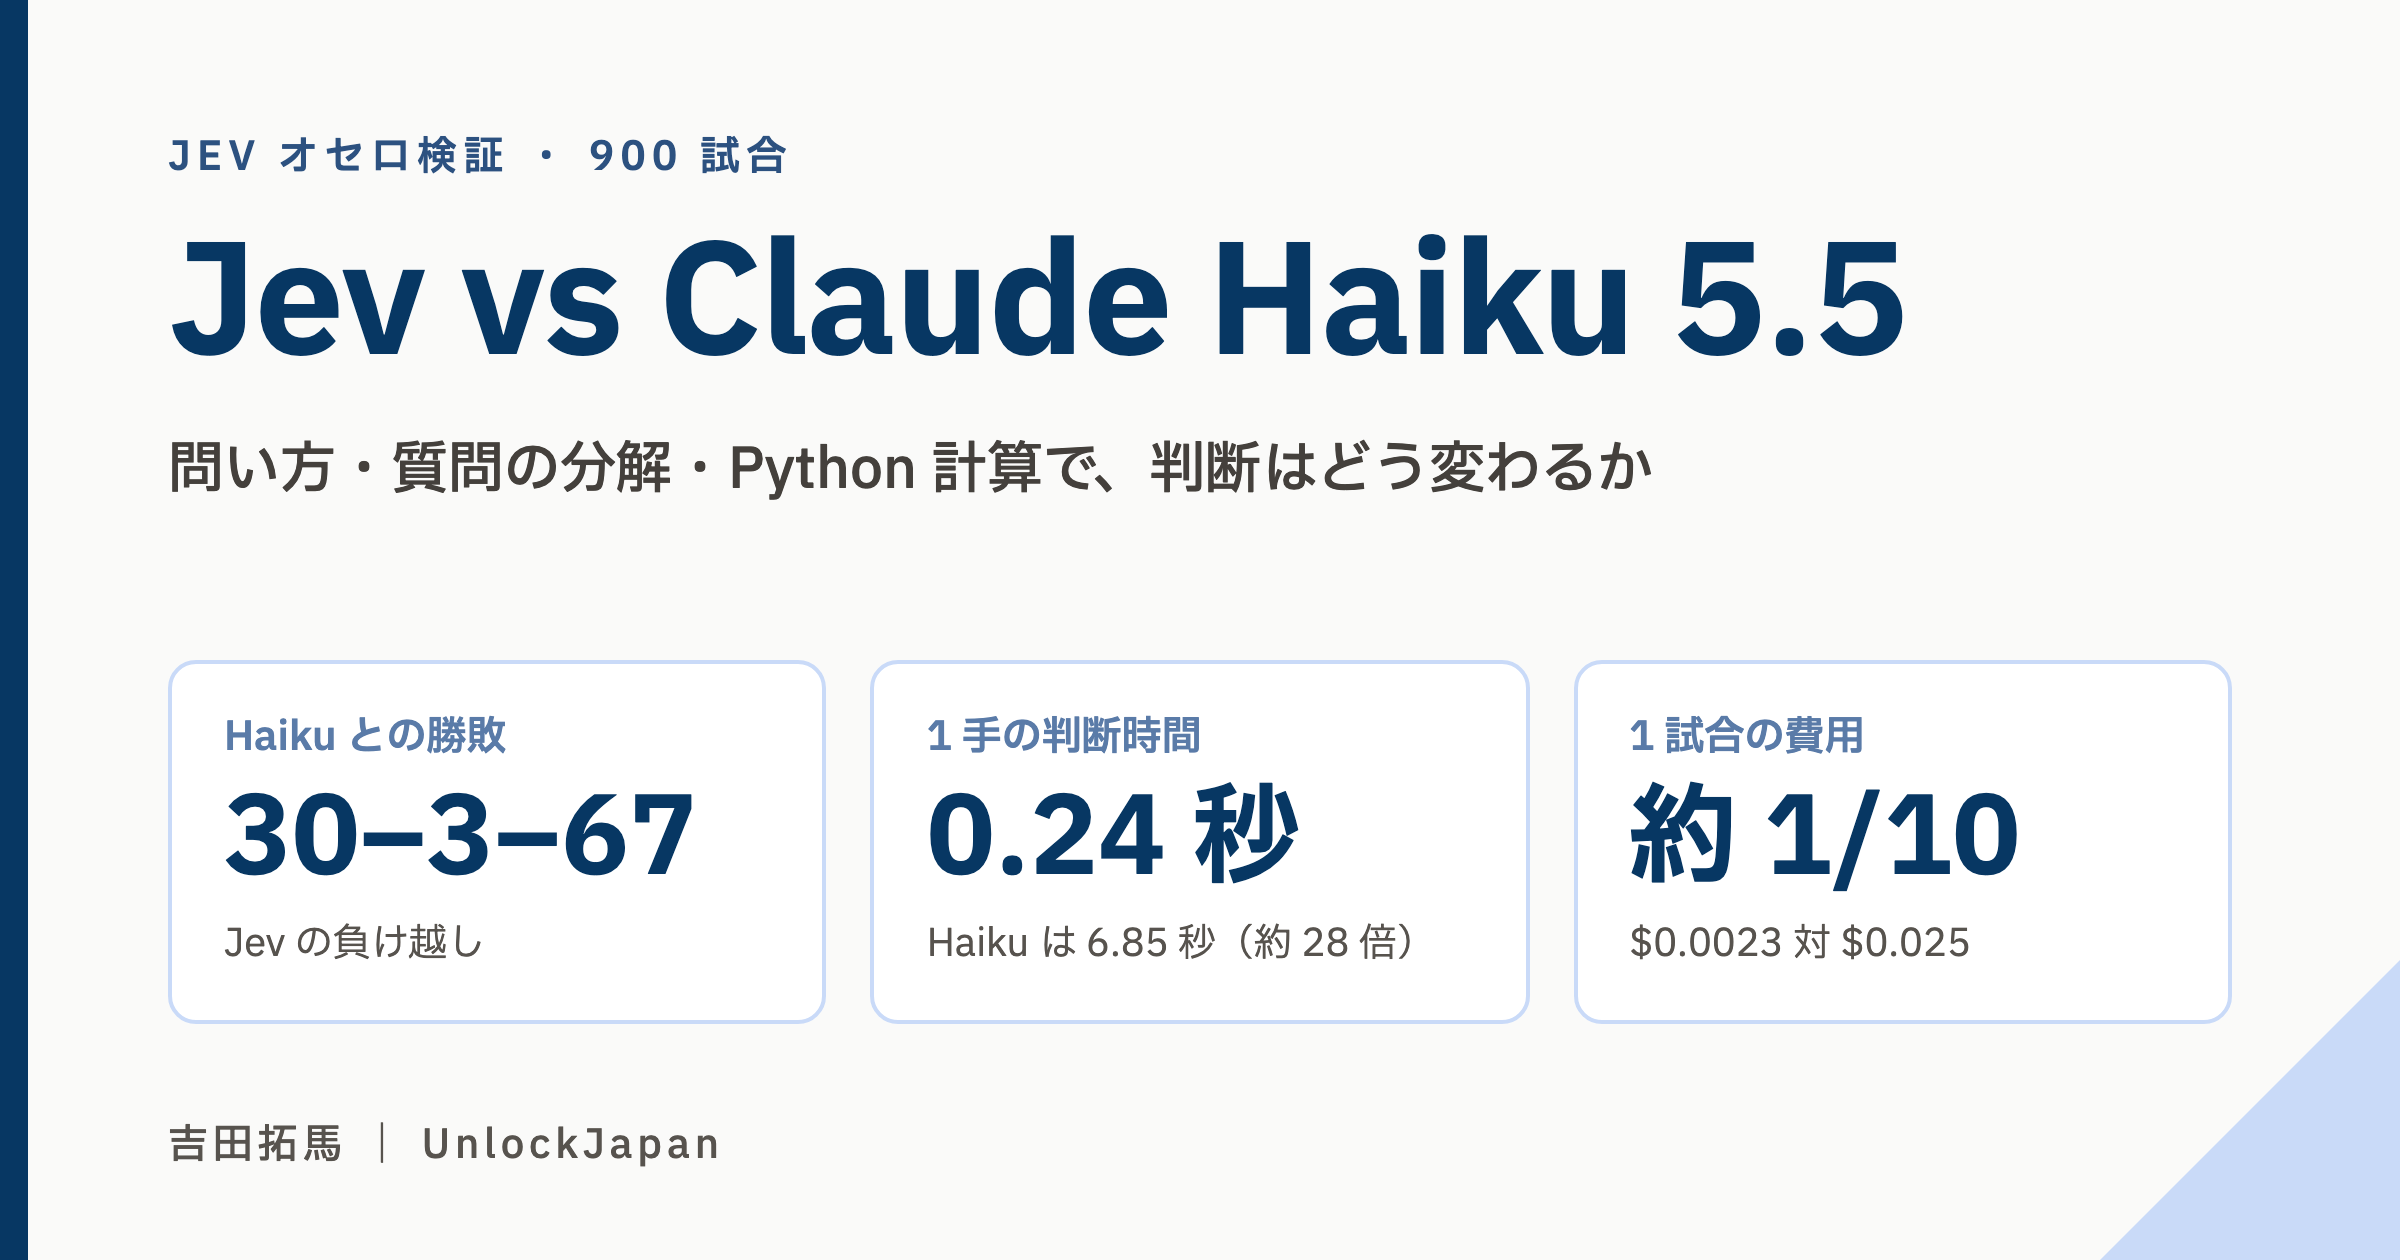
Jev オセロ検証では、確認項目を Python で計算して Jev に渡す方式(Python Atomic)が、同じ確認を Jev に聞く方式に70勝4分26敗で勝ちました。一方、Claude Haiku 5.5 には30勝3分67敗で負け越しました。1手の判断は Haiku の約28分の1の時間(0.24秒対6.85秒)、費用は約10分の1でした。
何を調べたか
TypeSafe の判断特化 AI「Jev」を、勝ち負けで判断の良し悪しを測りやすいオセロで検証しました。最終目標は「Jev を業務に組み込むと、汎用 LLM より良く・速く・安く判断できるか」です。オセロは盤面がすべて見えていてルールも決まっているので、Jev の答えが正しいかをプログラムで採点できます。
読み物としての実験記録は note に連載しています(記事の最後にリンクがあります)。このページは、その数字と条件をまとめた参照先です。
登場する方式
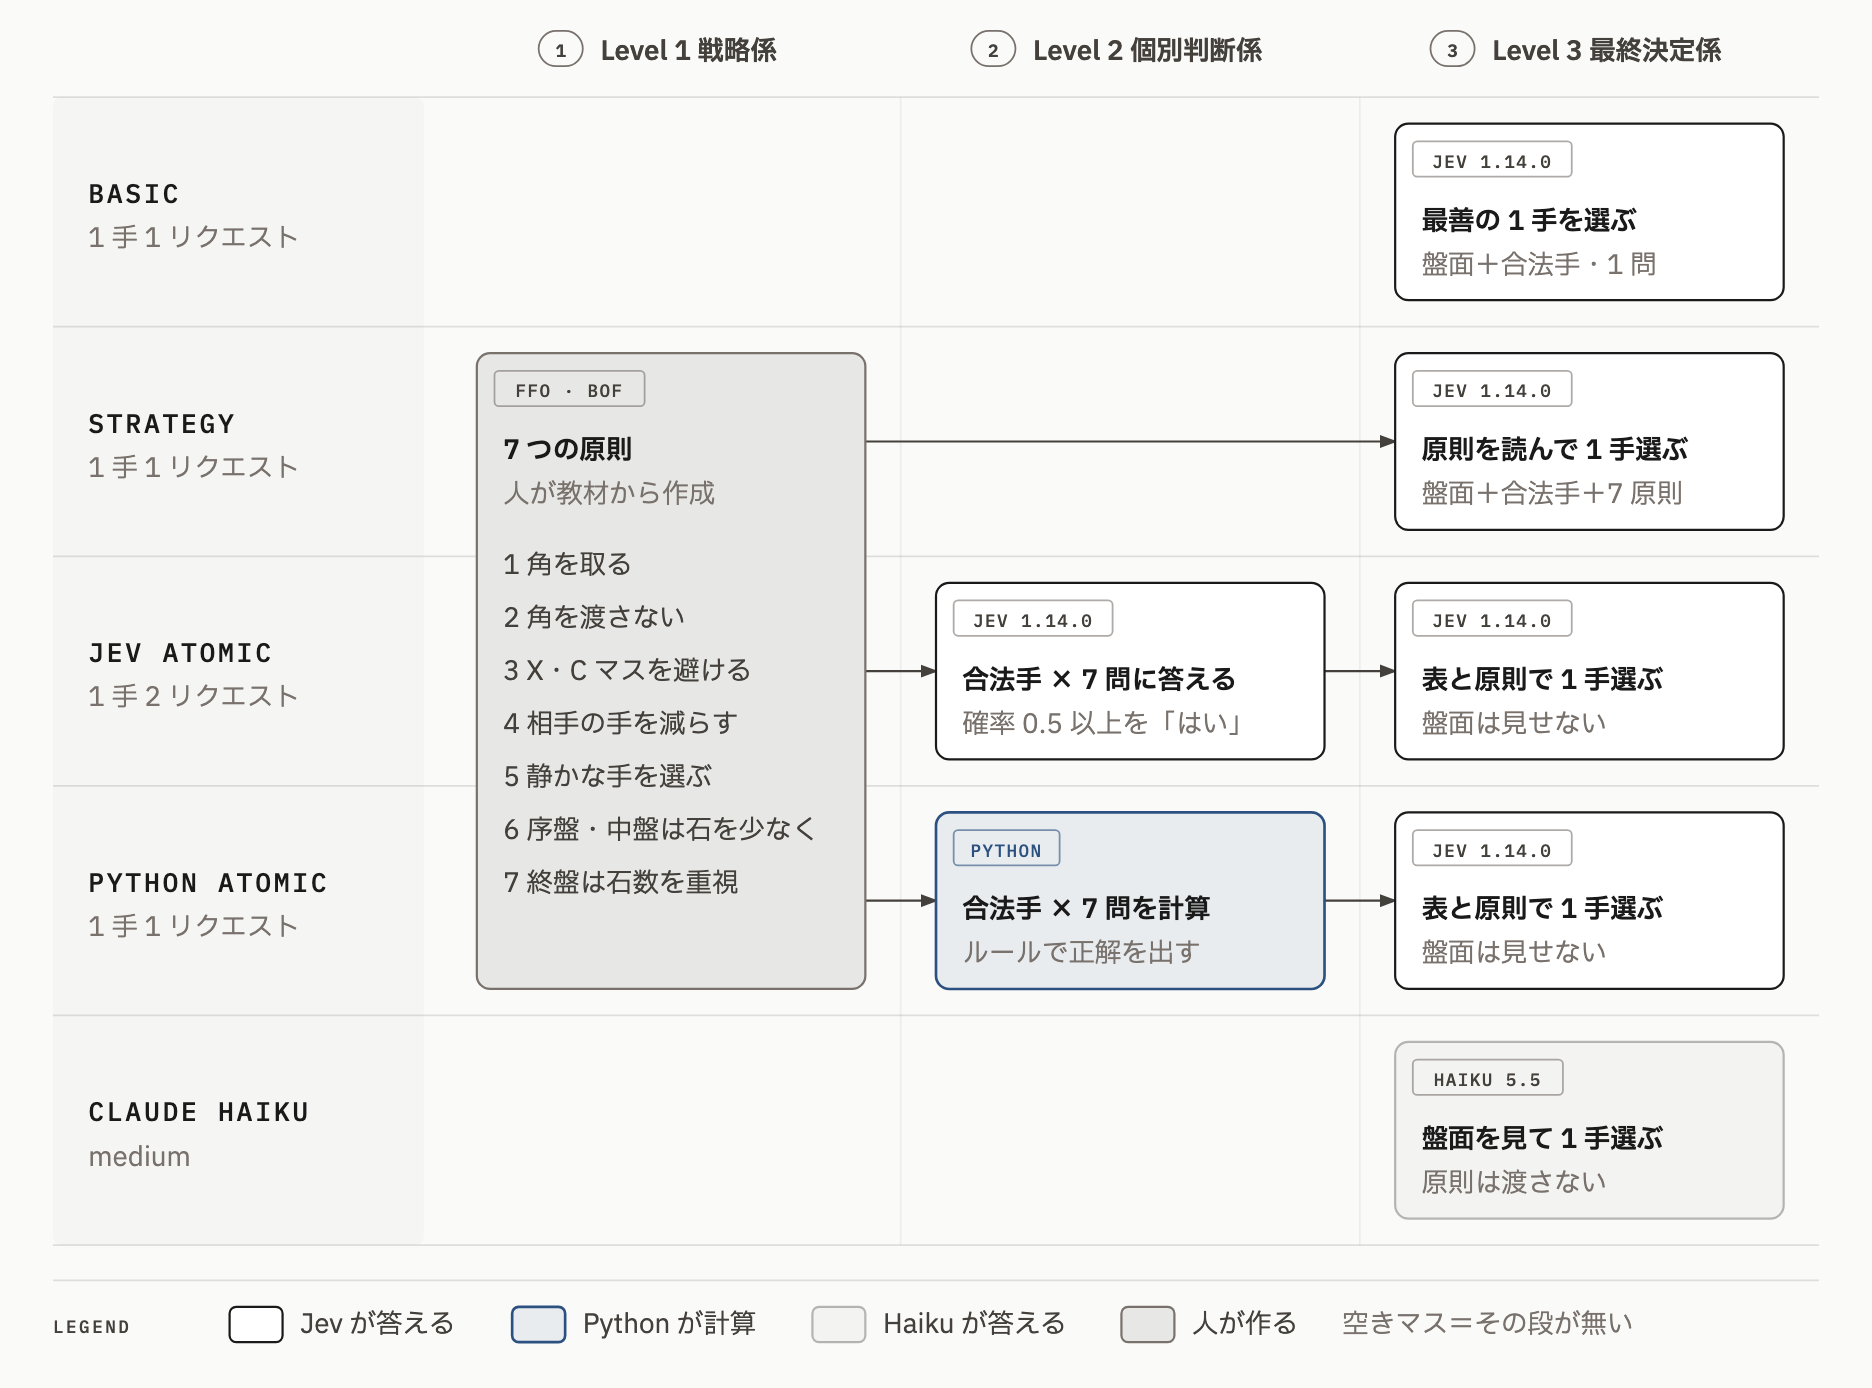
どの方式も、1手ごとに盤面と石を置ける場所(合法手)を受け取り、合法手の中から1つを選びます。違うのは、判断の材料を誰がどう用意し、最後に誰が手を選ぶかです。この検証では、判断を次の3段に分けて考えています。
- Level 1(戦略係):オセロの原則を決める
- Level 2(個別判断係):合法手ごとに、原則に関わる事実を確かめる
- Level 3(最終決定係):材料をもとに1手を選ぶ
Basic
- モデル:Jev 1.14.0(
jev-1.14.0)。TypeSafe の HTTP API で呼びます。 - 渡すもの:盤面(8行の文字列。
B が黒、W が白、. が空き)、手番、合法手の一覧、手数。 - 問い:選択式(Choice)の問いを1問だけ聞きます。選択肢は合法手そのものです。原文は "Which move from
legal_movesgivescurrent_playerthe best chance of finishing the game with more discs than the opponent?"(どの手が、相手より多くの石で終局する見込みを最も高くするか)。 - 1手のリクエスト:1本。
- 打つ手:Jev が返す
choice(確率が最も高い選択肢)をそのまま打ちます。選択肢ごとの確率と確信度は記録するだけで、手は変えません。
Strategy
Basic と同じ問いに、オセロの原則を書き添えて1問で聞きます。原則は2通り試しました。
- 原則を雑に(v1):「角を取る」「相手の合法手を減らす」「自分の石を確定石にする」「最終的な石数を増やす」の4つと、「どれが大事かは局面で変わる」という一文。出典は付けていません。
- 7つの原則(v2):フランスオセロ連盟(FFO)の教材を主に、英国オセロ連盟(BOF)の教材も参考にまとめた次の7つ。どれが大事かは局面と段階によって変わり、いつも最優先の原則は無い、と書き添えます。
- 角を取る(角の石は返されない)
- 相手が次の手番で角に打てるようになる手を避ける
- 空いている角の隣のマス(X マスと C マス)を、はっきりした理由がなければ避ける
- 相手の打てる手を減らし、自分の手を増やす
- 空きマスに接する石を返さない「静かな手」を選ぶ
- 序盤と中盤は、石を少なめにする
- 終盤は、相手より多くの石で終えることを重く見る
v2 では、局面の段階(空きマスが41以上なら序盤、21〜40なら中盤、20以下なら終盤)も一緒に渡します。Jev に送る文はすべて英語で、上の日本語は訳です。
- モデル:Jev 1.14.0
- 1手のリクエスト:1本
- 打つ手:Jev が返す
choice(確率が最も高い選択肢)をそのまま打ちます。選択肢ごとの確率と確信度は記録するだけで、手は変えません。
Jev Atomic
7つの原則を、合法手ごとの「はい / いいえ」の質問に分けて Jev に聞き(Level 2)、その答えの表から最終の手を Jev に選ばせます(Level 3)。「狭く独立した質問をいくつも聞き、答えを組み合わせる」という、TypeSafe の公式の手引きが勧める作り方に沿っています。
Level 2:合法手1つにつき次の7問を、「はい」の確率を0〜1で返す型(Noul)で聞きます。合法手が8つなら56問で、全部を1本のリクエストにまとめます。確率が0.5以上なら「はい」と読みます。
| # | 質問 | 対応する原則 |
|---|---|---|
| 1 | その手は角(A1・H1・A8・H8)か | 1 |
| 2 | その手を打ったあと、相手は次の手番で角に打てるか | 2 |
| 3 | その手は、角が空いている X マス(B2・G2・B7・G7)か | 3 |
| 4 | その手は、角が空いている C マス(A2・B1・G1・H2・A7・B8・H7・G8)か | 3 |
| 5 | その手を打ったあと、相手の合法手は今より増えるか | 4 |
| 6 | 静かな手か(返した石のどれも、打ったあとに空きマスに接していないか) | 5 |
| 7 | 返す石が、ほかのどの合法手と比べても同じか多いか | 6・7 |
Level 3:盤面は見せません。手番、合法手、手数、局面の段階、7問の短い文、合法手ごとの「はい / いいえ」の表と、7つの原則を渡し、選択式で1手を選ばせます。盤面を渡すと、Jev が表を使わずに最初から選び直すおそれがあるためです。
- モデル:Jev 1.14.0(Level 2・Level 3 とも)
- 1手のリクエスト:2本(Level 2 と Level 3)
- 打つ手:Level 3 の
choiceをそのまま打ちます。Python は、合法手かどうかを確かめるだけです。
実験の初期には、4つの観点をそれぞれ選択式で聞き、その多数決で手を決める版(Atomic v1)も試しました。この記事の数字には含めていません。
Python Atomic
Jev Atomic の Level 2 の7問を、Jev に聞かずに Python がオセロのルールから計算します。7問とも盤面と合法手から答えが1通りに決まるので、すべて正解です。計算は1手あたり約0.5ミリ秒でした。
Level 3 は Jev Atomic と同じです。同じ局面で Level 2 の答えが同じなら、Jev に送るリクエストは1バイトも変わりません。Level 3 には、Level 2 を誰が答えたかを伝えていません。
- モデル:Level 3 だけ Jev 1.14.0
- 1手のリクエスト:1本(Level 3 のみ)
- 打つ手:Level 3 の
choiceをそのまま打ちます。Python は手を選びません。Python の計算と反対の手を Jev が選んでも、その手を打ちます。
Claude Haiku 5.5
- モデル:
claude-haiku-5-5、effort は medium - 渡すもの:盤面・手番・合法手・手数(Basic と同じ情報)。システムプロンプトで盤面の読み方を説明し、相手より多くの石で終局する見込みが最も高い手を1つ選んで、JSON で返すよう求めます。原則は渡していません。
- 1手のリクエスト:1本
- 打つ手:返ってきた手をそのまま打ちます。
- 時間と費用の数え方:判断時間は、CLI が報告する API の応答時間です(CLI の起動時間は含みません)。費用は、CLI が返す API の定価での換算額です。
Router(Jev+Haiku)
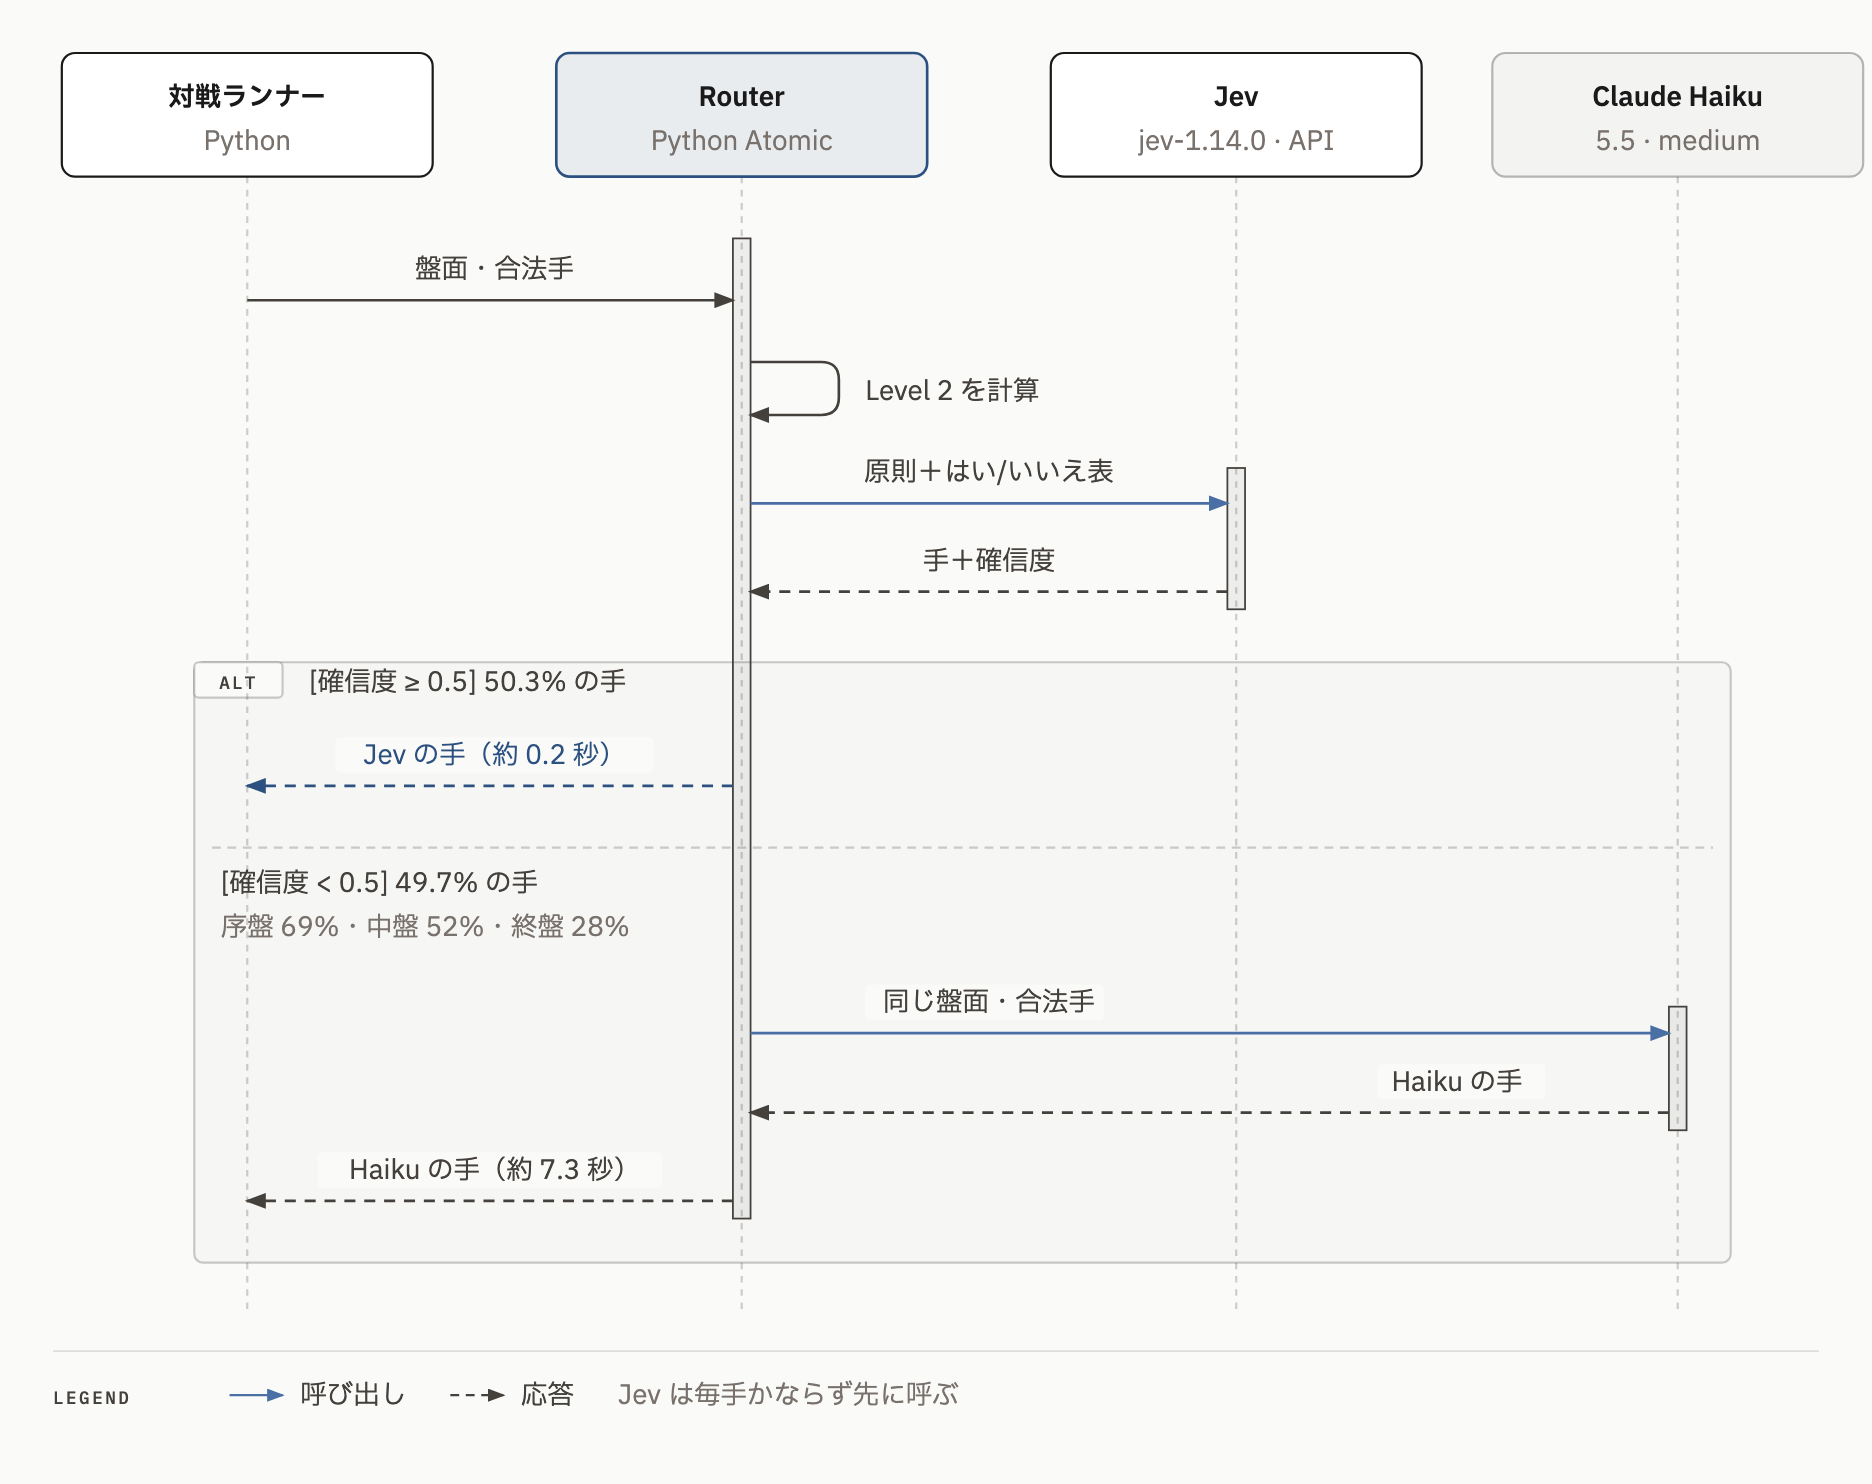
毎手、まず Python Atomic で判断し、Level 3 で Jev が返す確信度(confidence)で振り分けます。
- 確信度が0.5以上:Jev が選んだ手を打ちます(ちょうど0.5も Jev の手)。
- 確信度が0.5未満:Jev に渡したのと同じ盤面・手番・合法手(同じ並び順)・手数を Claude Haiku に渡し、Haiku の手を打ちます。
閾値の0.5は、TypeSafe の公式ドキュメントにあるサンプルの値で、ほかの値は試していません。Haiku に任せる手でも Jev は必ず先に呼ぶので、その時間と費用も数えています。
- モデル:Jev 1.14.0 と Claude Haiku 5.5(どちらも単独のときと同じ設定)
- 1手のリクエスト:1〜2本
共通の条件
- 各組100試合で、先手と後手を50試合ずつ入れ替えました。
- 合法手の並び順は、局面ごとにシャッフルしました。並びは乱数の種・試合番号・手数だけで決まり、両方のプレイヤーに同じ規則を使います。Jev 1.13 の「最初の選択肢を選びがち」という癖が、結果に混ざらないようにするためです。
- Jev に送る文は、すべて英語です。公式に、英語が最も精度が高いと書かれているためです。
- 合法手でない答えは、別の手に置き換えません。同じ入力で3回まで頼み直します。
- 1手の時間制限はありません。安全装置として、1回の問い合わせにタイムアウトを設けています。
- Jev の API には、温度や乱数の種を指定する項目がありません。
- Jev の費用は、入力トークン数 × 0.042ドル/100万トークン(出力は無料)の見積もりです。実際の請求額ではありません。
結果
勝敗は左側の方式から見た値です。どの組も100試合で、先手と後手を交互に入れ替えています。
| 対戦 | 勝ち | 引き分け | 負け | 決着した試合の勝率 | 95% の幅 | p 値 |
|---|---|---|---|---|---|---|
| Jev 1.14.0 対 1.13.0(Basic どうし) | 63 | 2 | 35 | 64% | 54〜74% | 0.006 |
| Strategy(原則を雑に)対 Basic | 55 | 2 | 43 | 56% | 46〜66% | 0.27 |
| Strategy(7つの原則)対 Basic | 71 | 2 | 27 | 72% | 63〜81% | <0.001 |
| Jev Atomic 対 Basic | 82 | 1 | 17 | 83% | 74〜90% | <0.001 |
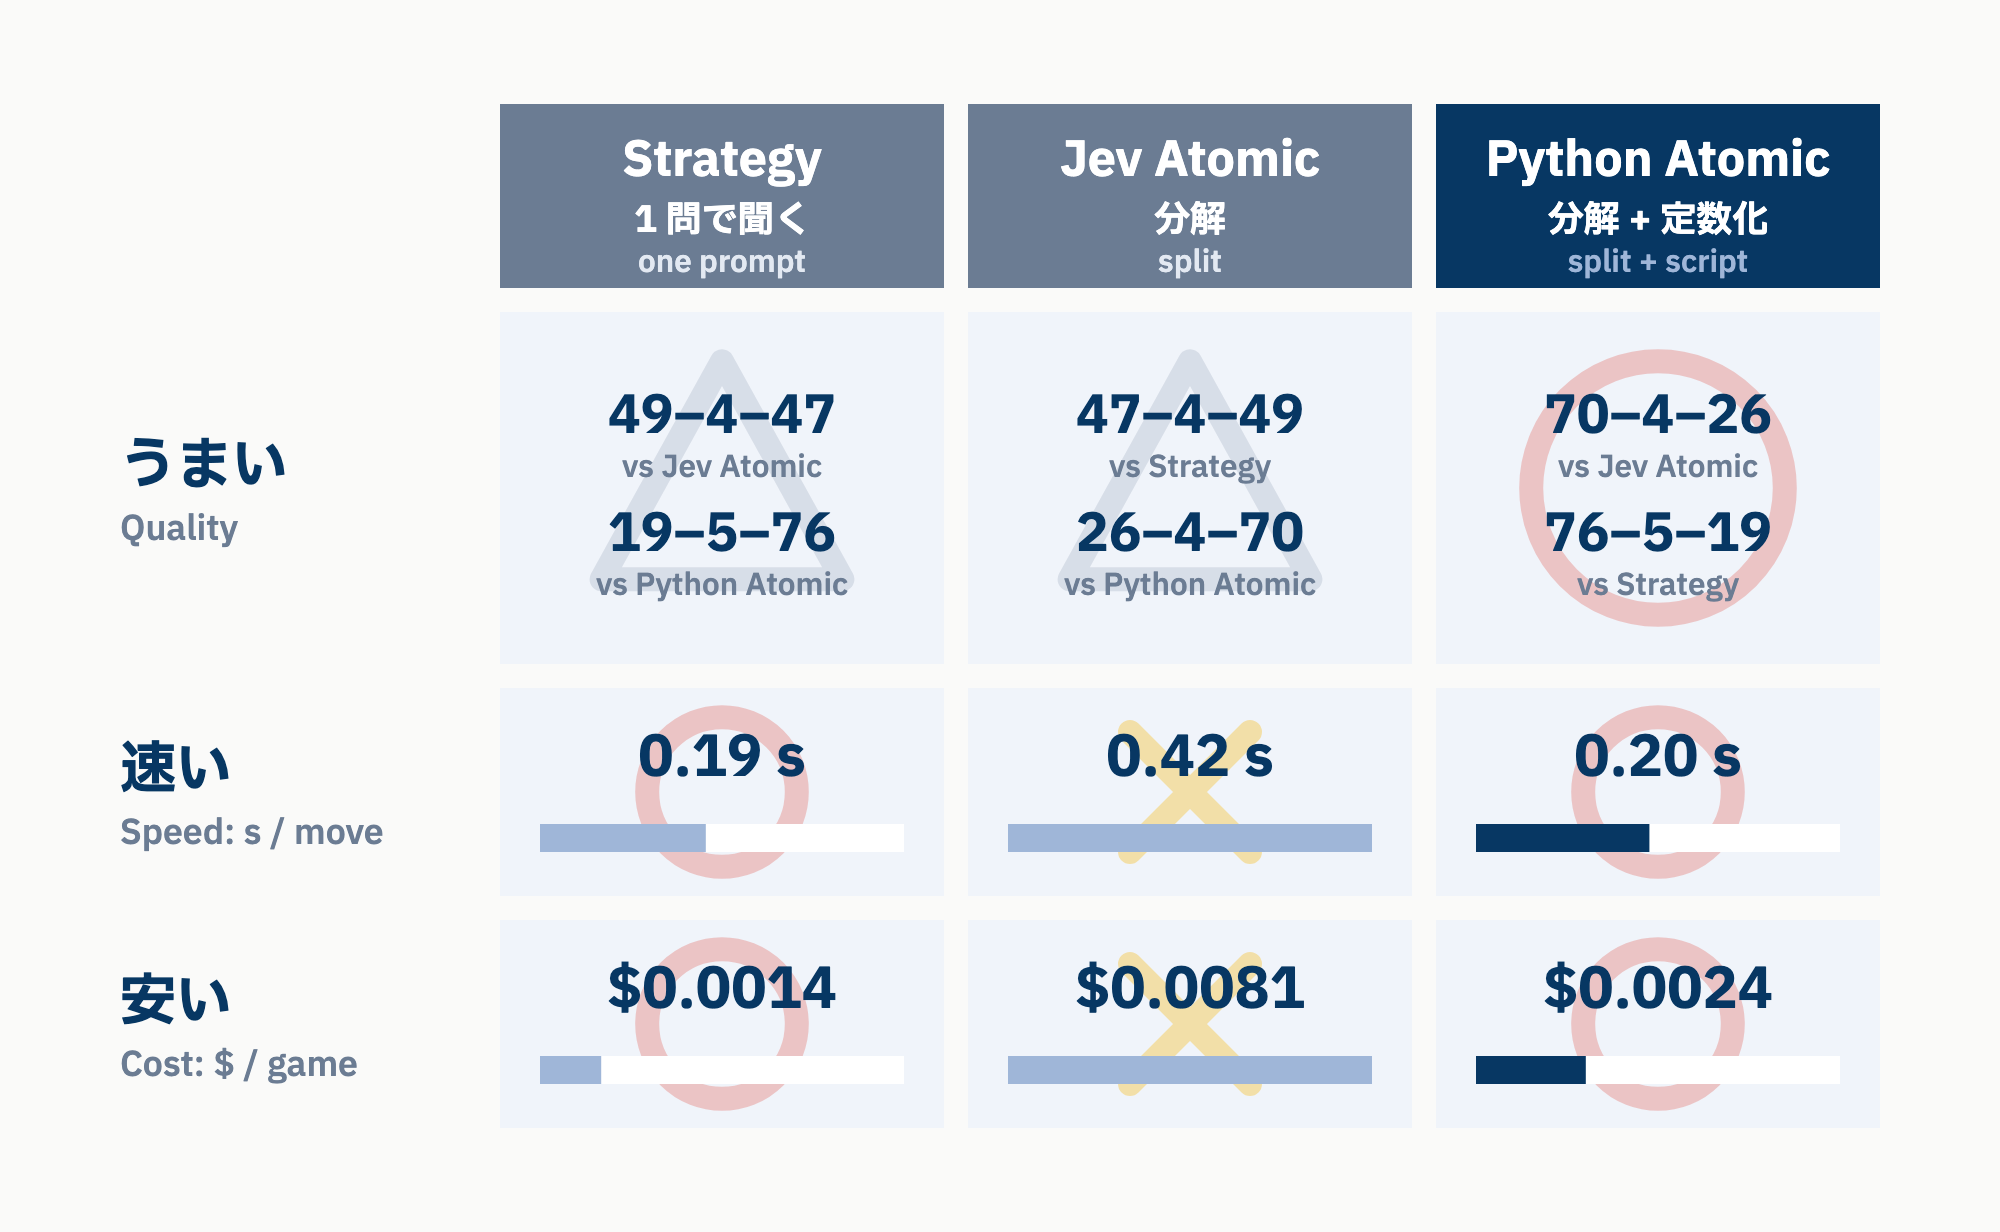
| Jev Atomic 対 Strategy | 47 | 4 | 49 | 49% | 39〜59% | 0.92 |
| Python Atomic 対 Jev Atomic | 70 | 4 | 26 | 73% | 63〜81% | <0.001 |
| Python Atomic 対 Strategy | 76 | 5 | 19 | 80% | 71〜88% | <0.001 |
| Python Atomic 対 Claude Haiku 5.5 | 30 | 3 | 67 | 31% | 22〜41% | <0.001 |
| Router 対 Claude Haiku 5.5 | 40 | 6 | 54 | 43% | 32〜53% | 0.18 |
決着した試合の勝率は、引き分けを除いた試合のうち勝った割合です。95% の幅は正確な二項分布の区間(Clopper-Pearson)、p 値は「両者の強さが同じ」とした両側の二項検定です。100試合なので、小さな差は見逃している可能性があります。
速さと費用
| 方式 | 1手の判断時間(平均) | 1試合の費用 |
|---|---|---|
| Strategy | 0.19秒 | 約0.0014ドル |
| Jev Atomic | 0.42秒 | 約0.0081ドル |
| Python Atomic | 0.20〜0.24秒 | 約0.0023〜0.0024ドル |
| Router | 約3.7秒 | 約0.015ドル |
| Claude Haiku 5.5 | 6.85秒 | 約0.025ドル |
Python Atomic の幅は、対戦相手が違う2回の実行の値です。Python の計算はそのうち約0.5ミリ秒でした。費用は、送ったトークン数に API の定価を掛けた見積もりで、実際の請求額ではありません。
Router では、2,996手のうち1,490手(約半分)を Haiku に任せました。Jev だけで済んだ手は約0.2秒、Haiku に回した手は約7.3秒で、平均が3.7秒です。序盤ほど Jev の確信度が低く、Haiku に回した割合は序盤69%・中盤52%・終盤28%でした。
分かったこと
原則の質が結果を分けた
雑に決めた4つの原則では、手の選び方は変わっても勝敗の差は偶然の範囲でした。角を打てる局面で実際に角を打った割合は、Basic の28%(669局面中188)に対し、原則を書き添えた方式では100%(212局面中212)でした。専門家の教材から作り直した7つの原則では、71勝2分27敗まで差がつきました。
分けるだけでは強くならず、答えの正しさが効いた
Jev Atomic の「はい / いいえ」の答えを、対局後にプログラムで採点しました。角か、角の隣か、のようにマスの位置で分かる質問はほぼ当てていました。一方、打ったあとの盤面を想像する質問や、ひっくり返る石の数を比べる質問は、ほとんど見分けられていませんでした。Jev 1.13 の公式の資料も、何段もの推論と数えることを苦手として挙げています。
この確認を Python の計算に替えると、Jev Atomic に70勝4分26敗で勝ちました。どの確認をどれだけ重く見て1手に決めるかは計算で決まらないので、そこは Jev に任せています。
汎用 LLM には負けたが、速さと費用では大きく勝った
最も強い Python Atomic でも、戦略を何も渡していない Claude Haiku 5.5 に負け越しました。ただし1手の判断は約28倍速く、費用は約10分の1です。大量の定型に近い仕分けや、相手を待たせられないその場の判断のように、速さと費用が効く場面では使いどころがあると考えています。
1.14.0 は 1.13.0 より強く、先頭の選択肢に偏る癖も減った
Jev 1.13 には「渡した選択肢の1番目を選びがち」という、公式ドキュメントにも書かれた癖があります。選択肢を毎回シャッフルして渡したうえで測ると、1番目に書いた手を選んだ割合は 1.13.0 が51%(偶然なら22%)、1.14.0 が33%(偶然なら16%)でした。減ってはいますが残っているので、1.14.0 でも選択肢を並べ替えて答えが変わらないか確かめるのが安全です。
比較条件と限界
- Jev は、版の比較を除いて 1.14.0。Claude Haiku は 5.5(effort は medium)で、盤面と置ける場所の一覧だけを渡し、戦略は渡していません。Jev 側は原則と計算を組み込んだ構成なので、両者に同じ作り込みをした比較ではありません。
- 結果はオセロという、盤面がすべて見えてルールが決まったゲームでのものです。確認をすべて計算に置き換えられたのも、確立した戦略の教材があったのもオセロだからで、現実の業務の判断に同じ差が出るとは限りません。
- Router の確信度の閾値は、公式ドキュメントのサンプルにある0.5だけを試しました。
- 時間は今回の実行環境と設定での値です。
UnlockJapan と TypeSafe の間に、提携・報酬・提供の関係はありません。
関連記事
note の連載(読み物版)